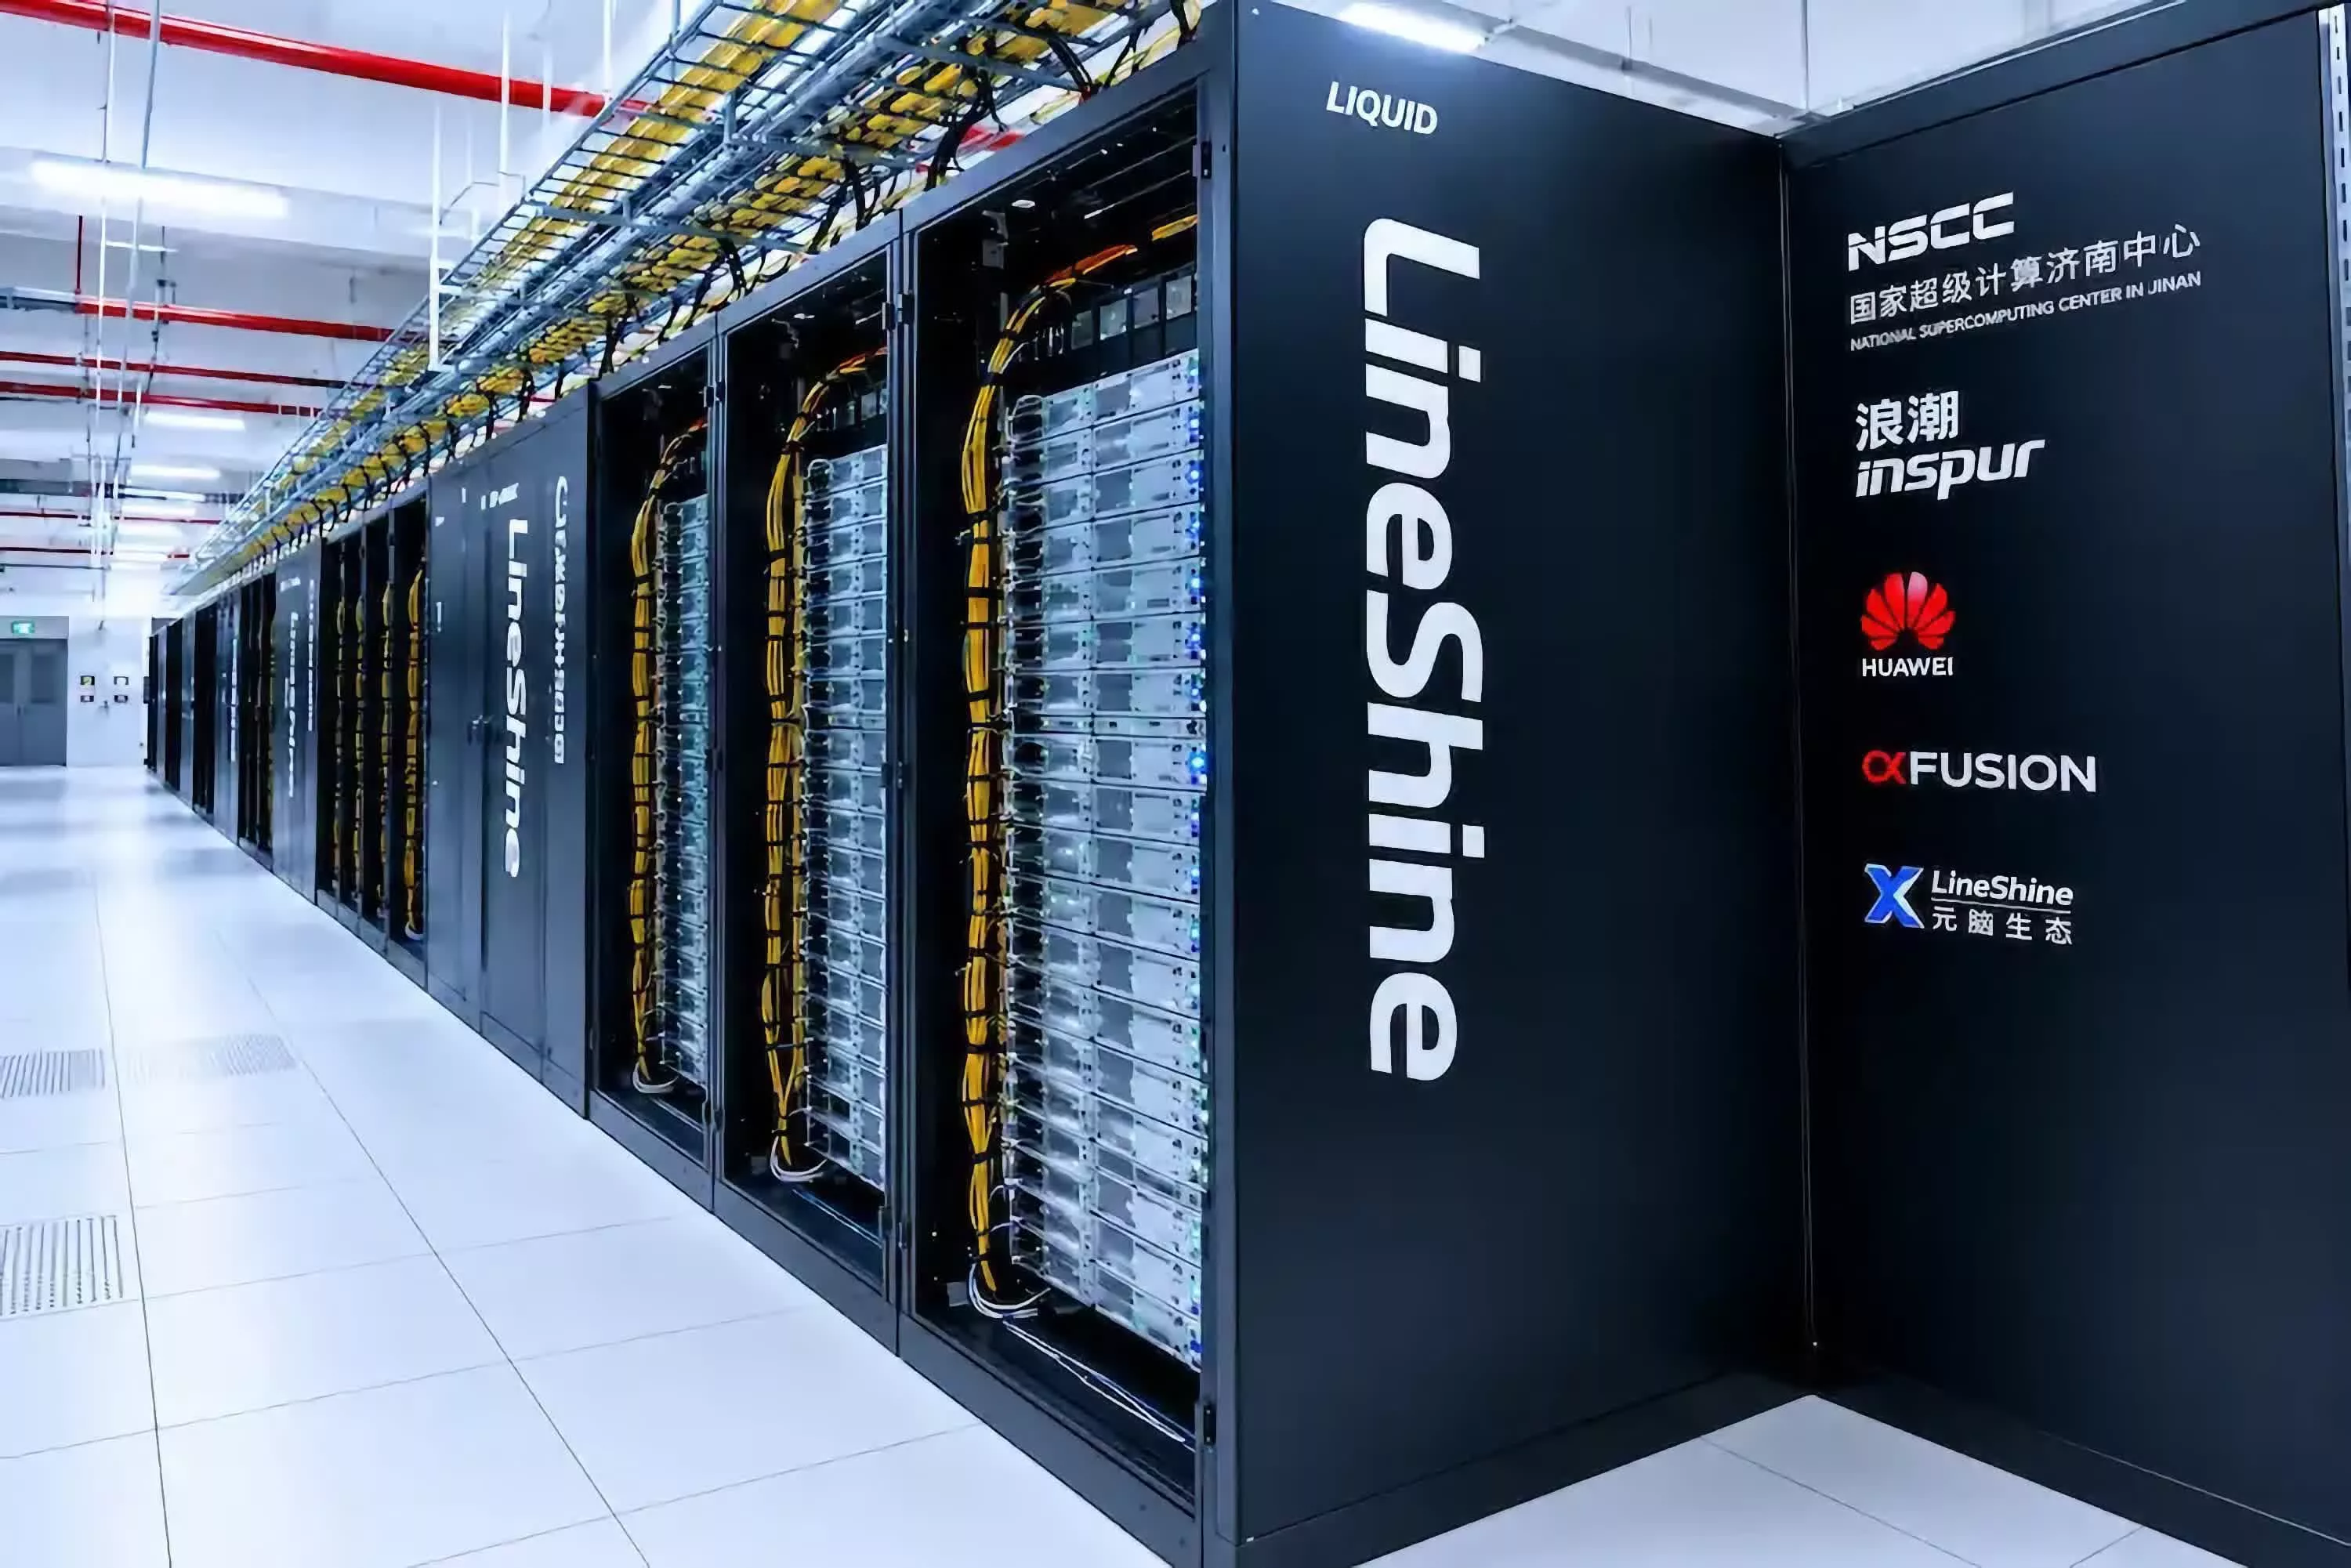





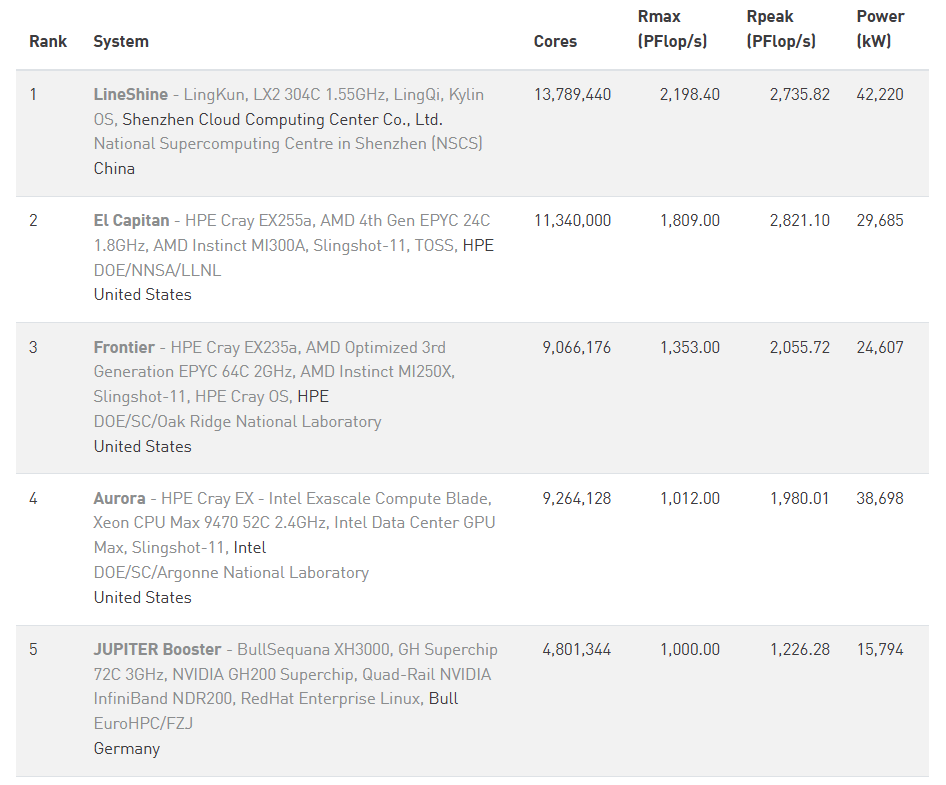
Класацията на суперкомпютърните клъстери TOP 500 беше обновена и начело отново е китайската система LineShine с производителност от 2,198 ExaFLOP/s при изчисления с двойна точност. Клъстерът използва разработената в Китай платформа LingKun и 304-ядрени процесори LX2 с архитектура ARMx9, чиито ядра работят на 1,55 GHz.
Системата разполага с общо 13 789 440 процесорни ядра, а комуникацията между процесорите се осигурява от междусистемната връзка LingQi, също разработена в Китай. LineShine се отличава с това, че разчита изцяло на централни процесори и работи без традиционни графични ускорители. При изпълнението на теста HPL консумацията му беше 42,22 MW.
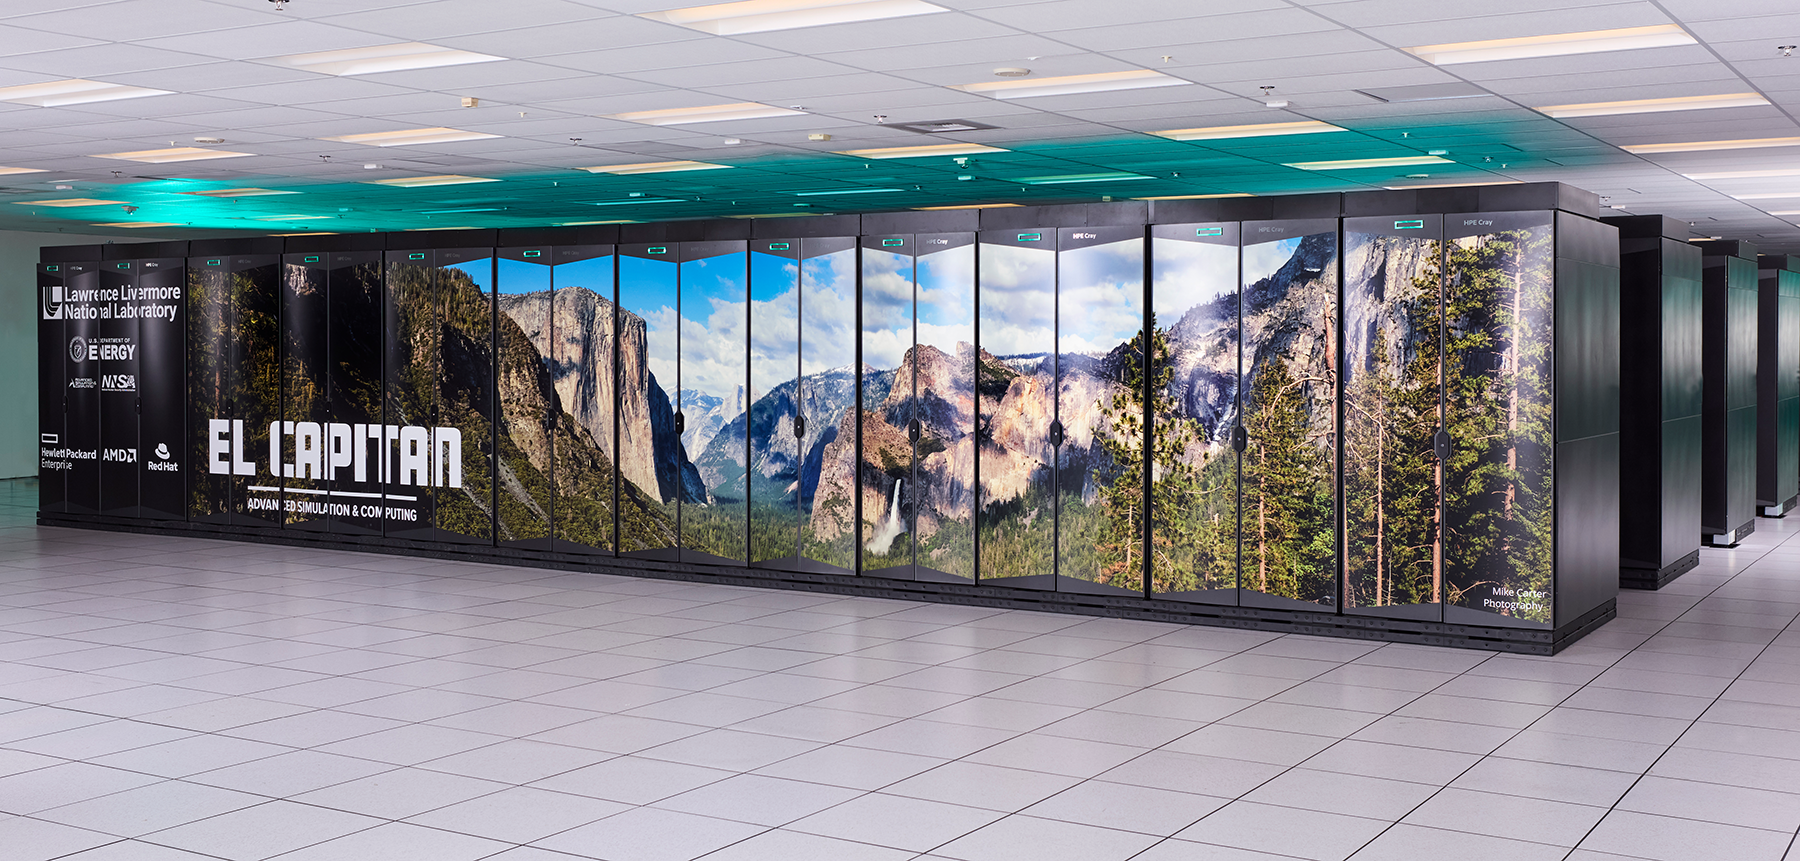
На второ място е El Capitan, най-бързият американски суперкомпютърен клъстер. Той е изграден на платформата HPE Cray EX255a и използва APU от серията AMD Instinct MI300A. В теста HPL системата достига максимална производителност от 1,809 ExaFLOP/s, също при FP64 изчисления. При консумация от 29,69 MW тя е значително по-енергийно ефективна от китайския клъстер.
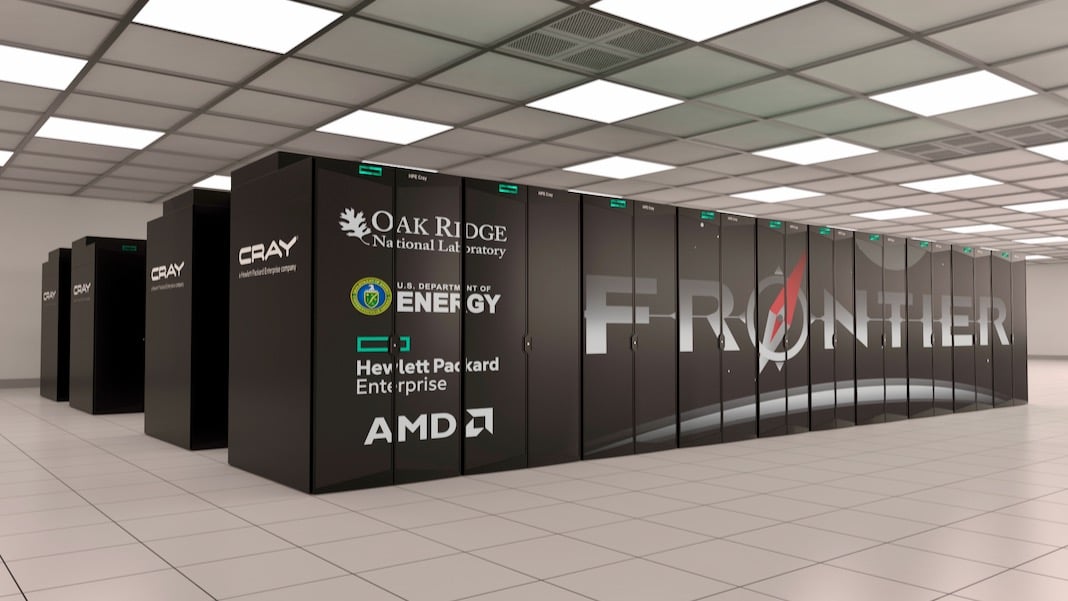
Третото място зае американският Frontier със сървърни процесори AMD Epyc от трето поколение и ускорители AMD Instinct MI250X. Той постига 1,353 ExaFLOP/s, също при изчисления с двойна точност (FP64), и консумира 24,61 MW.
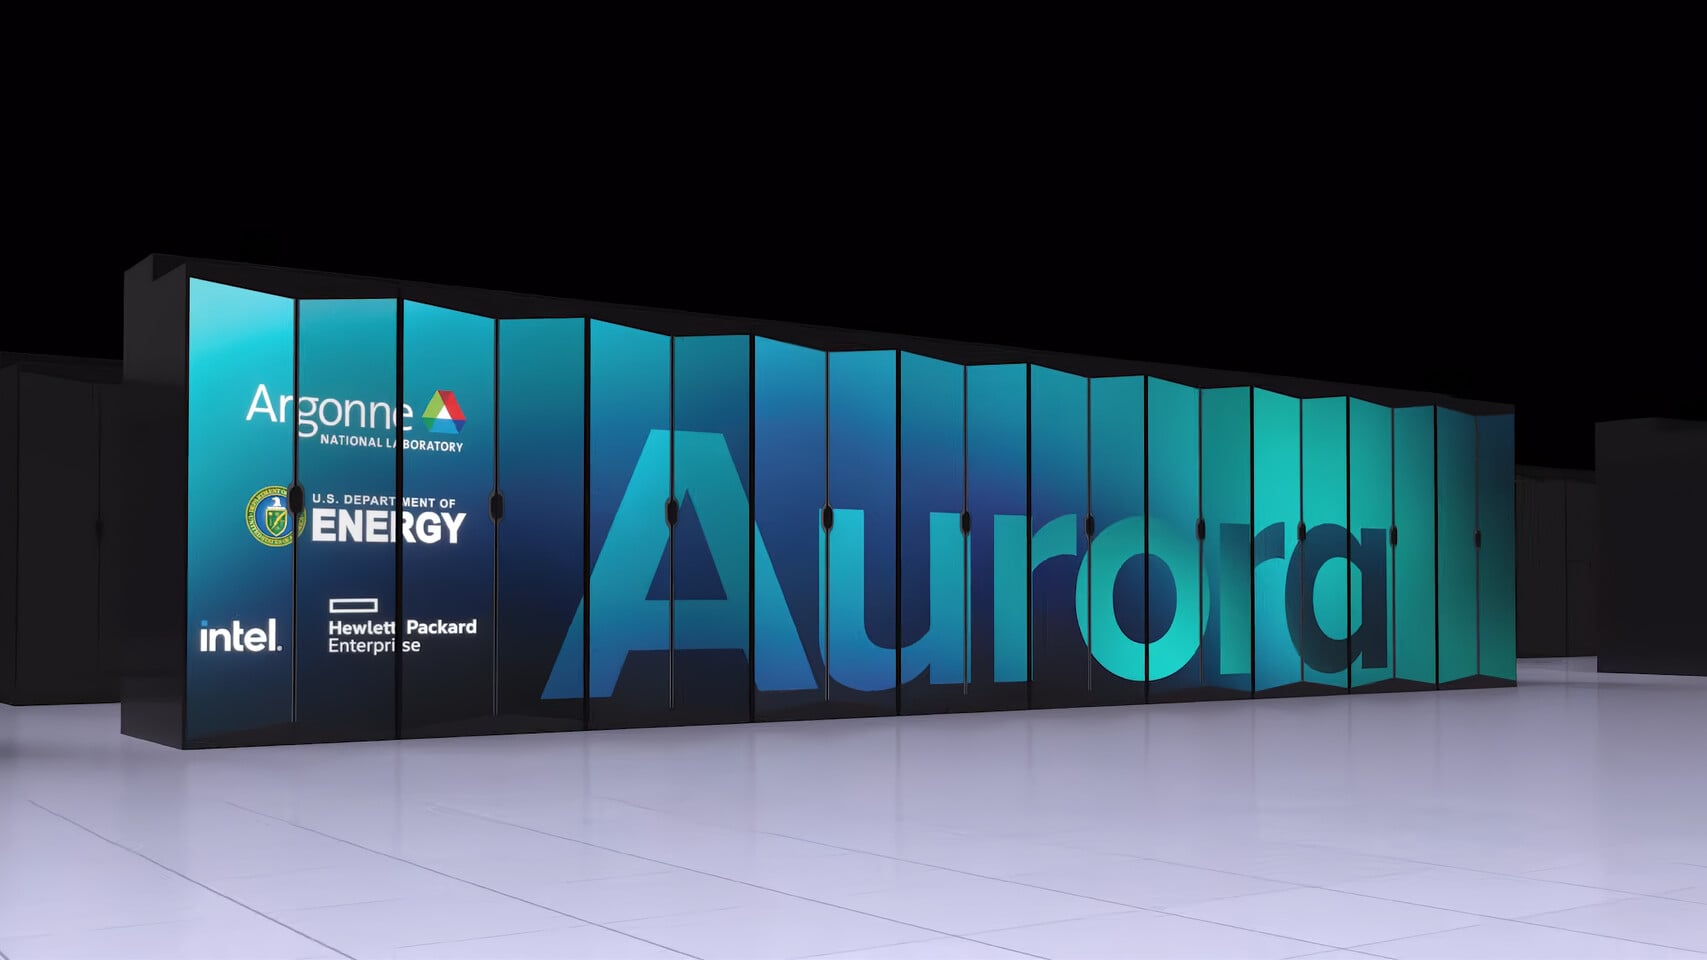
Четвъртото място е за друг познат американски клъстер, Aurora. Със сървърни процесори Intel Xeon CPU Max 9470 и ускорители Data Center GPU Max той достига пикова производителност от 1,012 ExaFLOP/s при FP64 и консумация от 38,70 MW. Така Aurora се нарежда малко над прага от 1 ExaFLOP/s, който го поставя сред най-мощните системи. Подобно на останалите споменати американски системи, Aurora използва Slingshot-11 за комуникация между платформите.
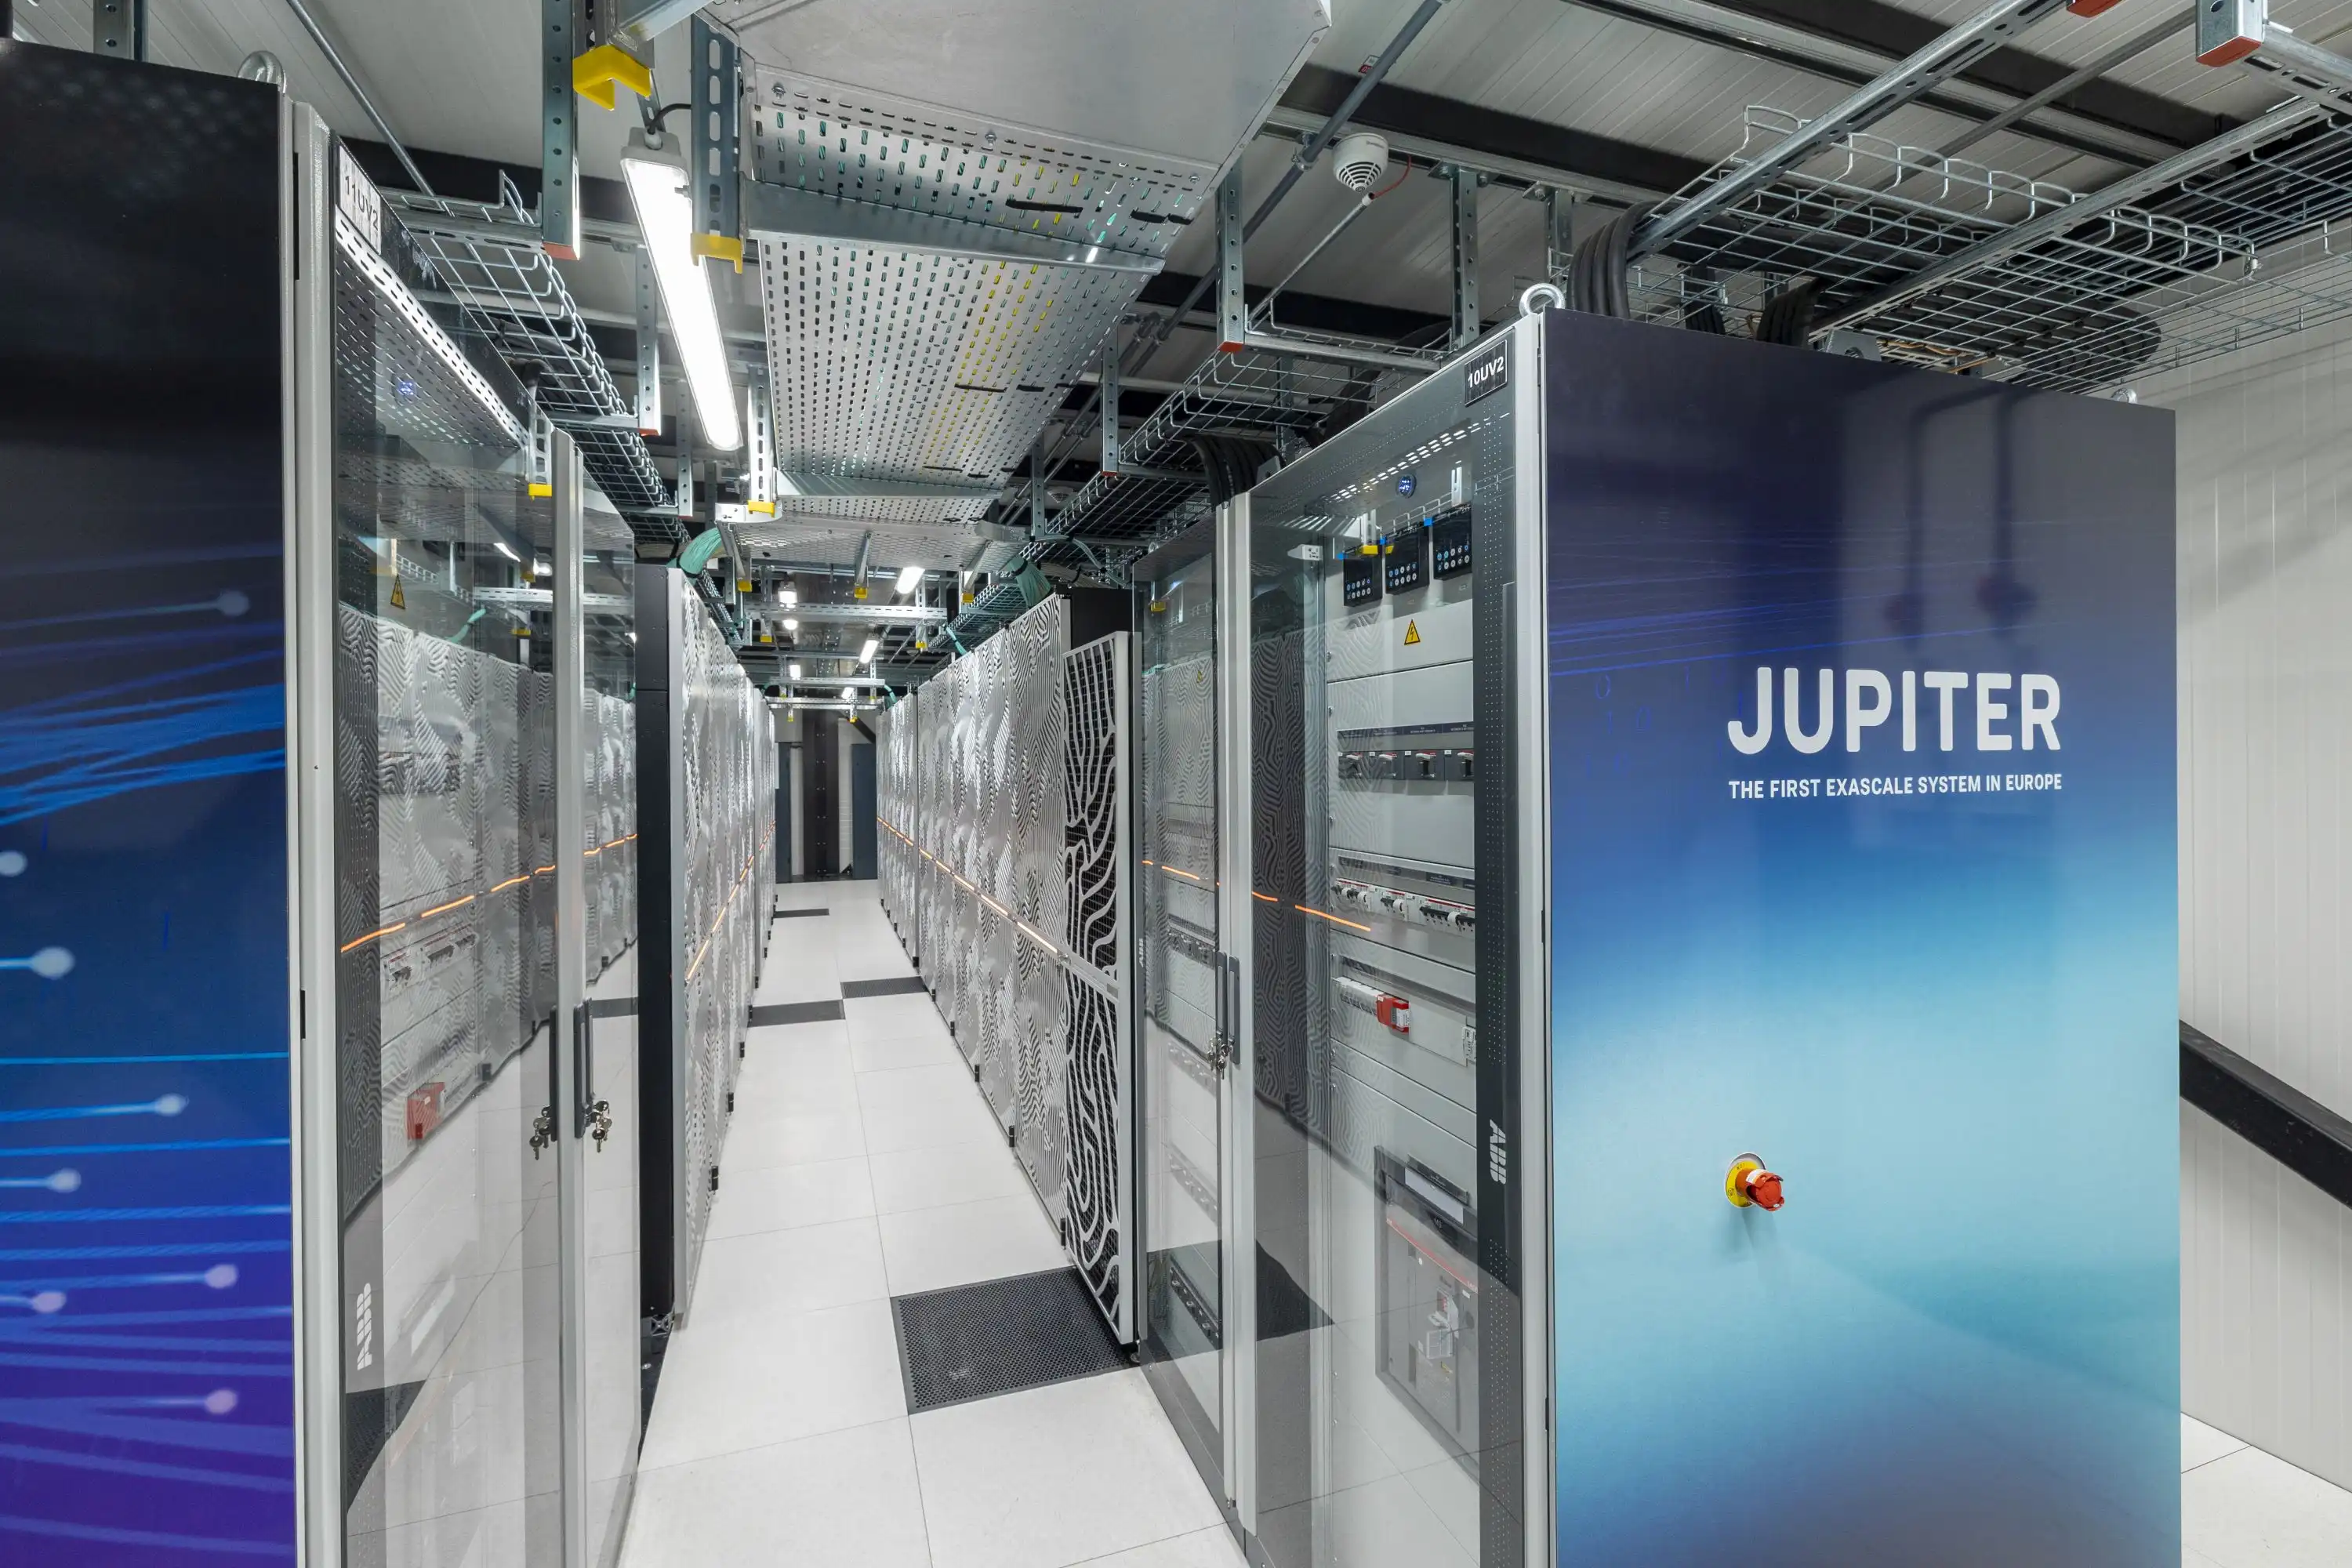
На пето място е суперкомпютърен клъстер, който се отличава с това, че работи в Европа, по-точно в Германия. Системата Jupiter Booster е изградена с комбинирани процесорни модули Nvidia GH200 Grace Hopper Superchip на платформата BullSequana XH3000 и използва четириканалната мрежова подсистема InfiniBand NDR200 на Nvidia. В теста LinPack HPL германският клъстер достига точно 1 ExaFLOP/s при FP64 изчисления и консумира едва 15,79 MW. Така той запазва първото си място по енергийна ефективност.
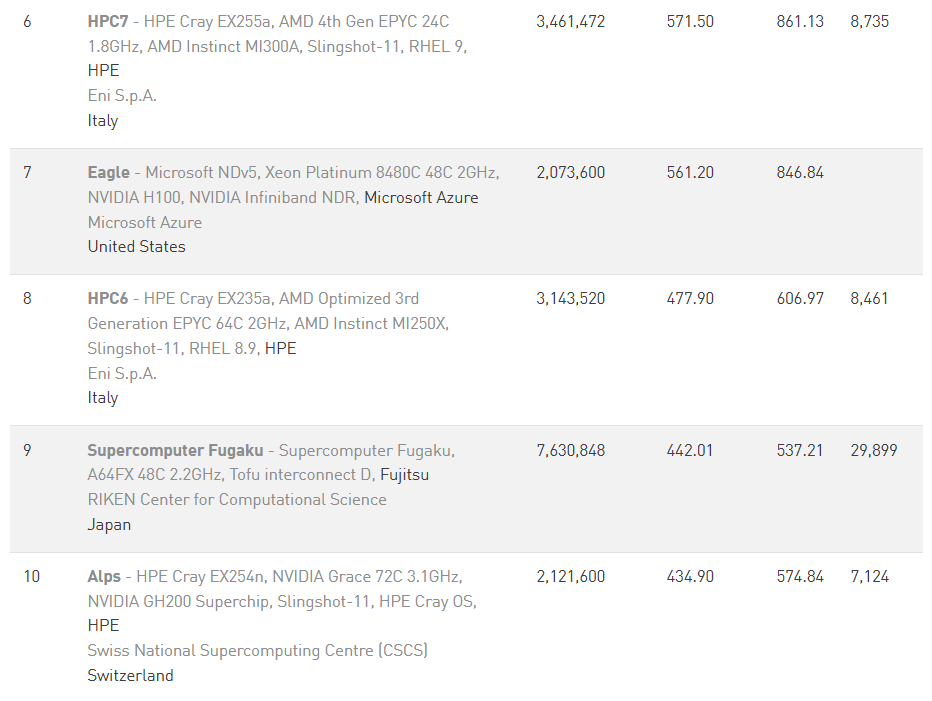
Този път в TOP 500 влязоха само 27 нови системи. Основната причина е, че ресурсите и хардуерните компоненти, които иначе биха отишли за класически суперкомпютри, се насочват към изграждането и развитието на центрове за данни за изкуствен интелект. Подреждането на десетте най-бързи клъстера и на десетте най-енергийно ефективни системи е същото като през юни. И в двете десетки няма нови участници. Прагът за влизане в класацията обаче се повиши. През юни за 500-ото място бяха достатъчни 2,662 PFLOP/s при FP64 изчисления, а през ноември минимумът вече беше 2,857 PFLOP/s. Нарасна и делът на клъстерите в TOP 500, които използват някакъв вид ускорител. През юни те бяха 275, а през ноември броят им достигна 291.
Най-бързият нов участник след юнското издание на класацията е южнокорейският HANGANG на KISTI Supercomputing Center. Клъстерът достига 346,6 PFLOP/s при FP64 изчисления благодарение на платформата HPE Cray EX254n, оборудвана в случая с процесорни модули Nvidia GH200 Grace Hopper Superchip. Системата завърши теста с консумация от 5,789 MW, което показва високата ѝ енергийна ефективност.
Пълната класация TOP 500 е достъпна тук, а списъкът с десетте най-бързи суперкомпютърни клъстера може да се види тук.