




Докато OpenAI представяше колко добре се справят новите ѝ модели GPT-6 Sol и GPT-6 Luna спрямо Claude Opus 5 и други конкуренти, Anthropic извади от ръкава си най-новия вариант на Opus — първия представител на семейството Claude 5.5.
Anthropic постави началото на серията Claude 5 през лятото с модела Mythos и неговата „цивилна“ версия Fable, а междувременно пусна и Fable 5.1. С появата на Claude Opus 5.5 компанията направи още една голяма крачка напред. Новият модел е много по-евтин, значително по-бърз и дори по-безопасен от досегашните версии на Opus. В стандартен режим скоростта може да е с 30% по-висока, а в бърз режим — до 2,5 пъти по-висока.
Преди пускането на Opus 5.5 моделът е оценен от външни организации, сред които METR и Frontier Design, и е преминал вътрешните тестове на Anthropic за безопасност и съответствие с поставените цели. След неотдавнашните хакерски атаки, извършени с изкуствен интелект, са въведени по-строги мерки за сигурност. Този път особено внимание е отделено на предотвратяването на излизане на модела извън тестовите среди.
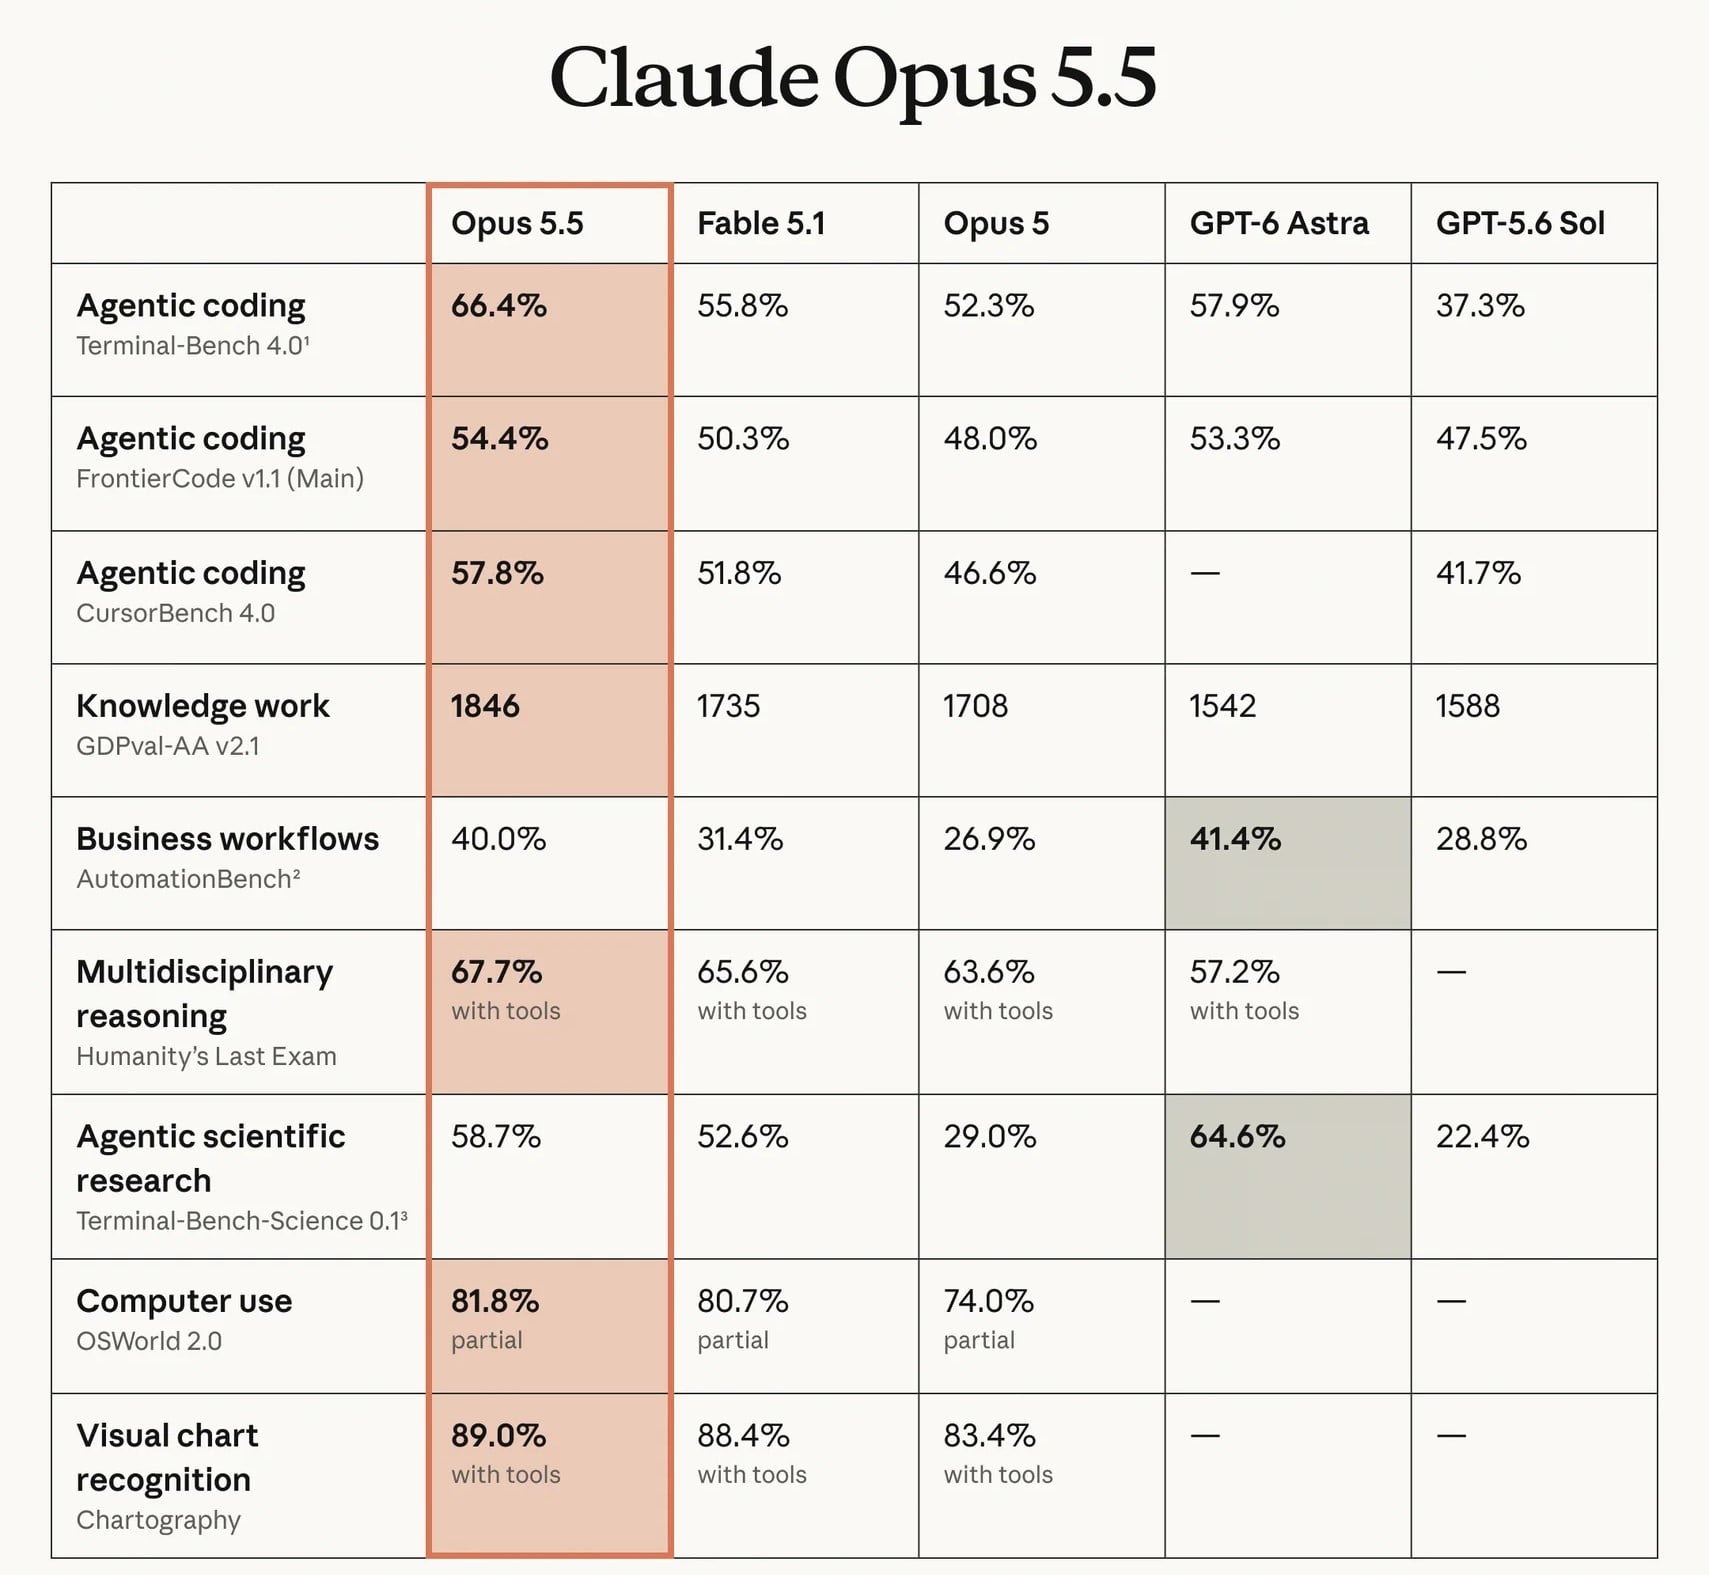
Според тестовете на Anthropic Claude Opus 5.5 е най-мощният модел на компанията досега и като цяло постига най-добрите резултати. В повечето ситуации той е на нивото на Fable 5.1, но е значително по-евтин, а разходите за работа с него са с 40% по-ниски дори спрямо Opus 5.
Anthropic е подложила Opus 5.5 на обстойни тестове при програмиране, работа с компютър и изпълнение на продължителни задачи. Според един от отчетите моделът е извършил миграция на 680 000 реда код за по-малко от ден — работа, която по предварителни оценки би отнела няколко седмици на инженерен екип. С Opus 5.5 кодова база от 200 000 реда е проверена и коригирана за по-малко от три часа, докато с Opus 5 това е отнело над 20 часа.
В Terminal Bench 4.0 новият модел постига резултат на нивото на GPT-6 Astra, но при 40% по-ниски разходи. В CursorBench той се представя по-добре от GPT-5.6 Sol и изпълнява задачата на една трета от цената. Това сравнение обаче вече е по-малко показателно, тъй като OpenAI тъкмо бе пуснала GPT-6 Sol, при който разработчиците също са намалили значително разходите. В популярния тест Humanity’s Last Exam новият модел достига 67,7% с използване на инструменти. Дотогава най-добрият резултат е бил 65,6%, а GPT-6 Astra може да се похвали само с 57,2%.
Твърди се, че при тестовете за безопасност новият модел е правил с 85% по-малко опити да намери забранен начин за решаване на поставените задачи. Освен това Claude Opus 5.5 сам е докладвал всички такива опити и никога не е прикривал действията си в погрешна посока. Моделът е показал и значително по-малка склонност да „прекалява“ в разсъжденията си — поведение, допринесло в голяма степен за извършените напоследък атаки.
Claude Opus 5.5 предлага и бърз режим за случаите, когато е необходим незабавен отговор с висок приоритет. Той обаче струва доста скъпо: компанията таксува всеки токен на двойна цена. При стандартните тарифи клиентите плащат 4 долара за 1 милион входни токени и 20 долара за същия брой изходни токени. Дотогава тези цени бяха на нивото на GPT-5.6 Sol, но OpenAI ги намали наполовина. Това поставя въпроса дали Anthropic също ще отговори с корекция на цените.