




След няколко отлагания DeepSeek, смятана за една от големите надежди на Китай, успя да пусне най-новото си семейство модели DeepSeek-V4, което ще се предлага в няколко размера. Обновяването е мащабно и обхваща почти всичко, но тази смяна на поколенията няма да разтърси света.
Серията DeepSeek-V4 използва усъвършенствана технология Mixture-of-Experts (MoE) и ще се справя особено добре с дълъг контекст. Способностите ѝ за логическо разсъждение ще бъдат значително подобрени, а моделите ще показват добри резултати и при решаването на задачи чрез агенти.
Първоначално компанията представи два варианта: DeepSeek-V4-Pro и DeepSeek-V4-Flash. Тя подчерта, че вече става дума за „революционен ИИ модел с 1 трилион параметъра“. Благодарение на новото поколение MoE системата ще работи с отлична ефективност. Според съобщението за постигане на висока производителност ще са необходими средно само 32–37 милиона активни параметъра, като максималният им брой може да достигне 49 милиона.
Според официалните данни DeepSeek-V4-Pro може да разполага с 1,6 трилиона параметъра, а DeepSeek-V4-Flash — с 284 милиарда. V4-Pro ще се използва за специализирани задачи и изследвания, докато V4-Flash ще отговаря бързо и ефективно на общи въпроси. Компанията е обучила новото поколение по различни от досегашните методи върху 33 трилиона токена. Използва се нова архитектура и са приложени множество оптимизации на системно ниво, за да се намалят необходимите изчислителни ресурси и потреблението на памет.
Моделът е проектиран с изначално мултимодална архитектура. Още от самото начало разработчиците са го подготвили да обработва едновременно текст, изображения, видео и аудио при изпълнението на задачи. DeepSeek-V4 може да работи самостоятелно като „агент“ и обещава особено добри възможности при програмиране. Всички технологични компании влагат сериозни усилия в усъвършенстването на генерирането на код, тъй като в момента именно това приложение носи най-много приходи.
В съобщението си DeepSeek постави силен акцент върху това, че отвореният модел вече ще предлага контекстен прозорец от 1 милион токена, подобно на конкурентите си. Google Gemini беше първият голям модел, при който разработчиците достигнаха 1 милион токена. Постепенно този размер се превръща в стандарт за индустрията, към който занапред ще се придържа всеки нов модел на DeepSeek. Според компанията това ще позволи на модела да работи с отлична точност дори при голям обем информация и дълъг програмен код.
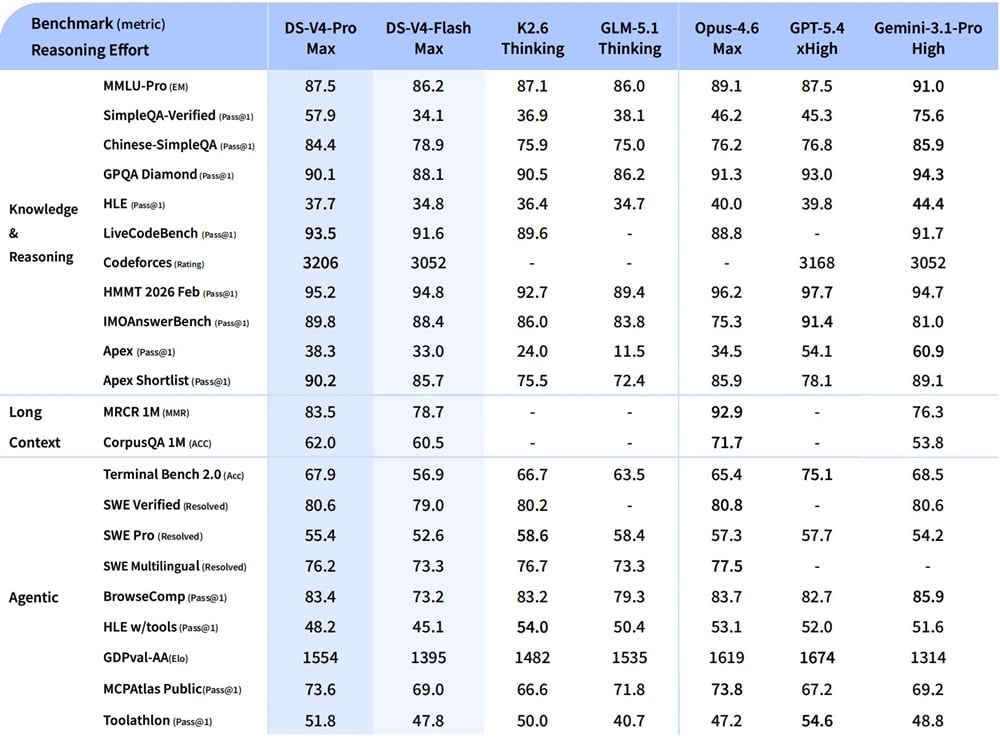
В популярния тест Humanity's Last Exam новото предложение на DeepSeek не се представя особено добре. С резултат от едва 35,9 % то изостава значително от Gemini 3.1, GPT-5.5 и Claude Opus 4.7. Всички водещи модели вече постигат около 40 %, а по-често и повече, дори без допълнителни инструменти. В теста SWE-Bench Pro, който оценява агентните възможности, GPT-5.5 вече достига 58,6 %, а Claude Opus 4.7 — 64,3 %. Новият DeepSeek-V4-Pro обаче постига само 55,4 %. В собствените си тестове компанията предпочита да сравнява новото си предложение с по-стари конкурентни модели, за да го представи в по-добра светлина.
В доклада си DeepSeek отбеляза също, че новото семейство V4 вече не е оптимизирано за графичните процесори на Nvidia, макар че ще работи и на хардуера на компанията. Заради американските санкции китайските разработчици бяха принудени да се насочат към местни хардуерни решения. Затова Huawei стана основният партньор за новия инструмент с изкуствен интелект. DeepSeek-V4 е „оптимизиран специално за чиповете Huawei Ascend 950PR и Cambricon MLU“.
Подобно на предшествениците си, новата серия се представя много добре по отношение на разходите. Затова, дори резултатите в тестовете да не са революционни, ценовата ѝ ефективност е безспорна. При DeepSeek-V4-Pro подаването на 1 милион входни токена струва най-много 1,74 долара, но кеширането на входните данни може да намали и тази сума. Генерирането на същия брой изходни токени струва 3,48 долара. При DeepSeek-V4-Flash обработката на 1 милион токена струва само 0,14 долара, а генерирането на 1 милион токена излиза 0,28 долара.