



Големите езикови модели и генеративният изкуствен интелект могат да доведат до значими научни открития. С помощта на съвременните системи вече са постигнати сериозни резултати. Това не е новост — ИИ се използваше за изследователски цели още преди ChatGPT, но сега OpenAI направи едно много необичайно съобщение.
Компанията е успяла да реши една от седемте Задачи на хилядолетието, формулирани от Математическия институт „Клей“ през 2000 г. Институтът обяви и внушителна парична награда за решаването им — по 1 милион долара за всяка задача.
OpenAI веднага уточни, че няма да претендира за наградата, но добави, че тази сума всъщност не би покрила разходите за откритието.
Компанията е успяла да реши проблема с уравненията на Навие–Стокс, които са на повече от 90 години и описват движението и течението на течностите. Досега от седемте задачи беше доказана само една — хипотезата на Поанкаре. За да постигне резултат, OpenAI вероятно е провела едно от най-интензивните изследвания в историята. По данни на компанията процесът е погълнал изчислителни ресурси за „няколко милиона долара“, въпреки че не е продължил дълго.
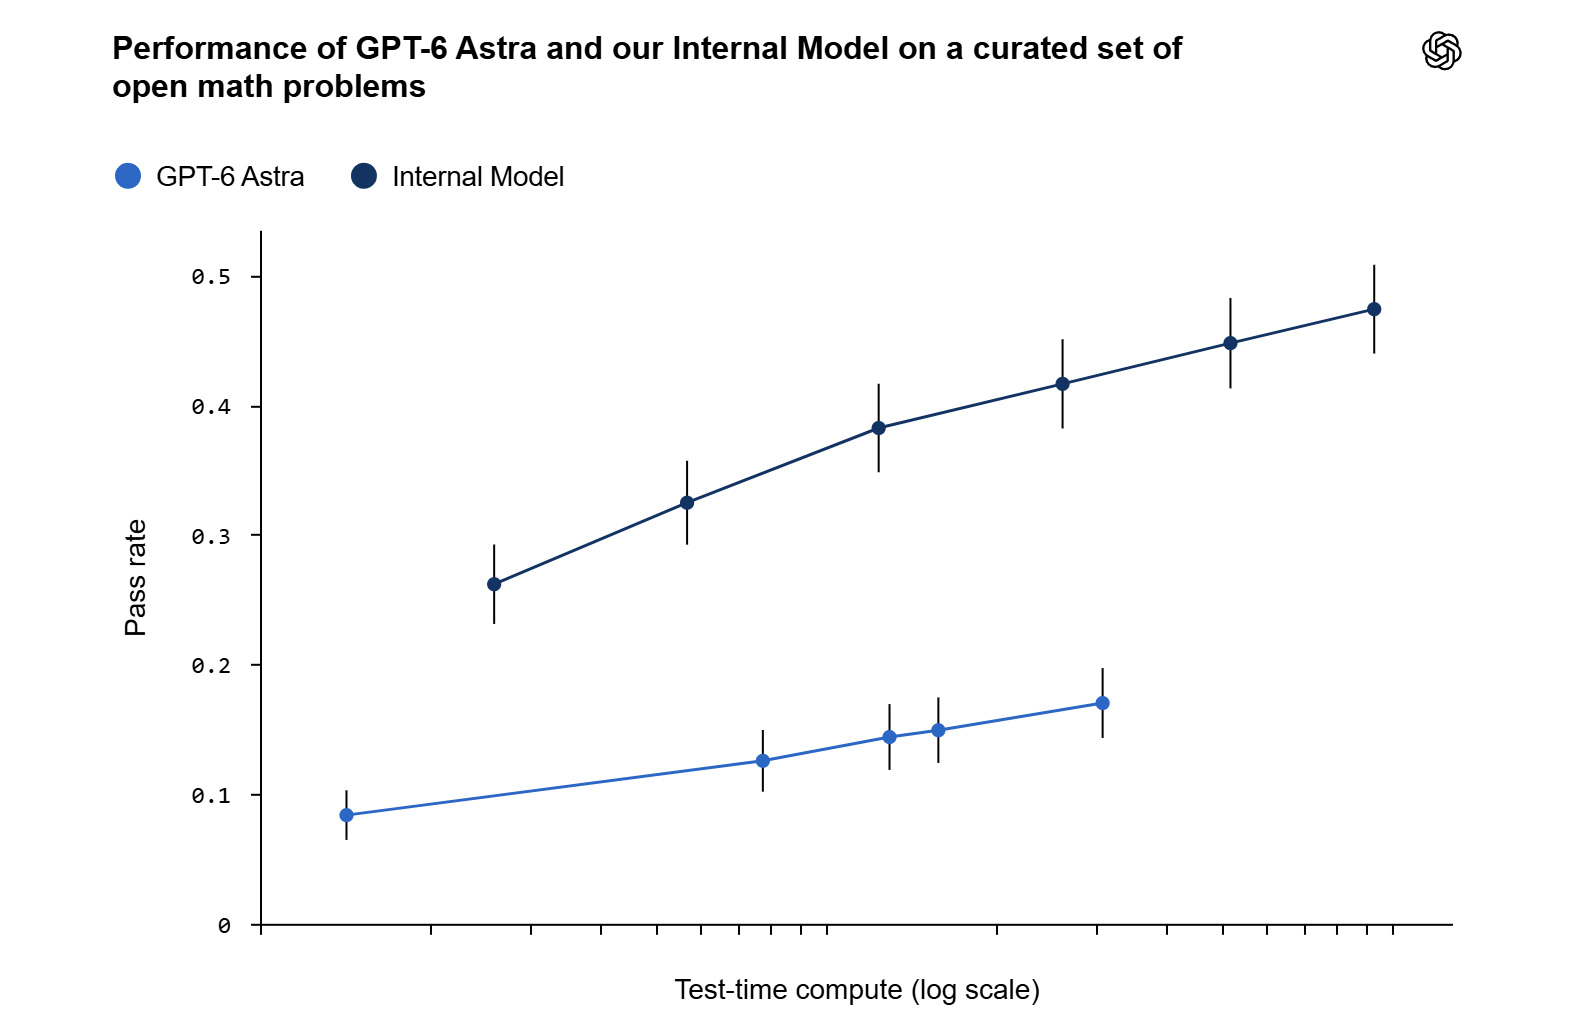
Усилията на OpenAI са дали резултат за 88 часа. На 28 август компанията е започнала да обучава нов вътрешен модел за задачата. Твърди се, че той се справя с решаването на математически проблеми близо три пъти по-добре от наскоро представения GPT-6 Astra, който сам по себе си донесе значителен напредък. Следователно, поне според описанието, става дума за наистина изключителен модел. В хода на изследването той е създал над 10 000 ИИ агента, които са работили почти едновременно и без прекъсване по решението.
Новината за доказването на една от Задачите на хилядолетието е радостна, но едно необичайно съвпадение оставя горчив привкус. Само ден по-рано математикът от Нюйоркския университет Tristan Buckmaster и изследователят от Anthropic Levent Alpöge са представили важни открития, свързани с уравненията на Навие–Стокс. Твърди се, че чрез контактите си в компанията Alpöge е научил, че OpenAI е разбрала за изследването им и може да е получила достъп до ключова информация.
Buckmaster разказва, че след като е научил, че OpenAI знае за постигнатите от тях резултати, се е свързал с компанията. Искал е да попита кога са започнали работа по проблема и с какви данни са обучили модела си. Разговорът между страните много бързо се е изострил и е прераснал в словесна разпра с тон, който съвсем не е обичаен за научните среди.
За точните обстоятелства около случая не се знае нищо, но Buckmaster дори допуска, че OpenAI може по някакъв начин да е получила достъп до работните сесии, записани в Codex, и да ги е използвала за обучението. В работата си математиците са използвали няколко езикови модела, включително ChatGPT. Сега професорът очаква OpenAI да публикува самото доказателство, тъй като то би могло да разкрие дали компанията е извършила злоупотреба.