



Краят на 2026 г. се очертава много динамичен за Anthropic. В дните преди 9 октомври компанията пусна почти едновременно два модела от семейството Claude 5.5 — Sonnet и Haiku. Това обаче е по-малкото предизвикателство пред нея, тъй като се подготвя за първично публично предлагане. Според появилата се информация гигантът в сектора на ИИ може да излезе на борсата през ноември.
Освен Claude Opus 5.5, предназначен за задълбочени аналитични разсъждения и вземане на сложни решения, под марката Claude вече са достъпни и Claude Sonnet 5.5 за всекидневна работа по разработка на софтуер и офис задачи, както и Claude Haiku 5.5 — бърз и евтин модел за масова употреба. Новите модели носят значителен напредък в ефективността и програмирането и се изправят като силни конкуренти срещу моделите GPT-6.
Спрямо Sonnet 5 моделът Sonnet 5.5 предлага подобрения в производителността, програмирането, работата с експертни знания, продължителните агентни задачи, разпознаването и интерпретирането на изображения, съвместната работа, скоростта и ефективността. Haiku 5.5 е най-подходящ за кратки и повтарящи се задачи като обобщаване, съкращаване на съдържание, заявки към бази данни и класификация. Освен това може да изпълнява задачи по програмиране като агент под ръководството на Claude Opus 5.5 и Claude Sonnet 5.5.
Claude Haiku 5.5 е първият модел от класа Haiku с достатъчно добри възможности, за да подлежи на фина настройка. Това позволява на потребителите да постигнат според нуждите си баланс между минимални разходи и по-високо ниво на знания на модела.
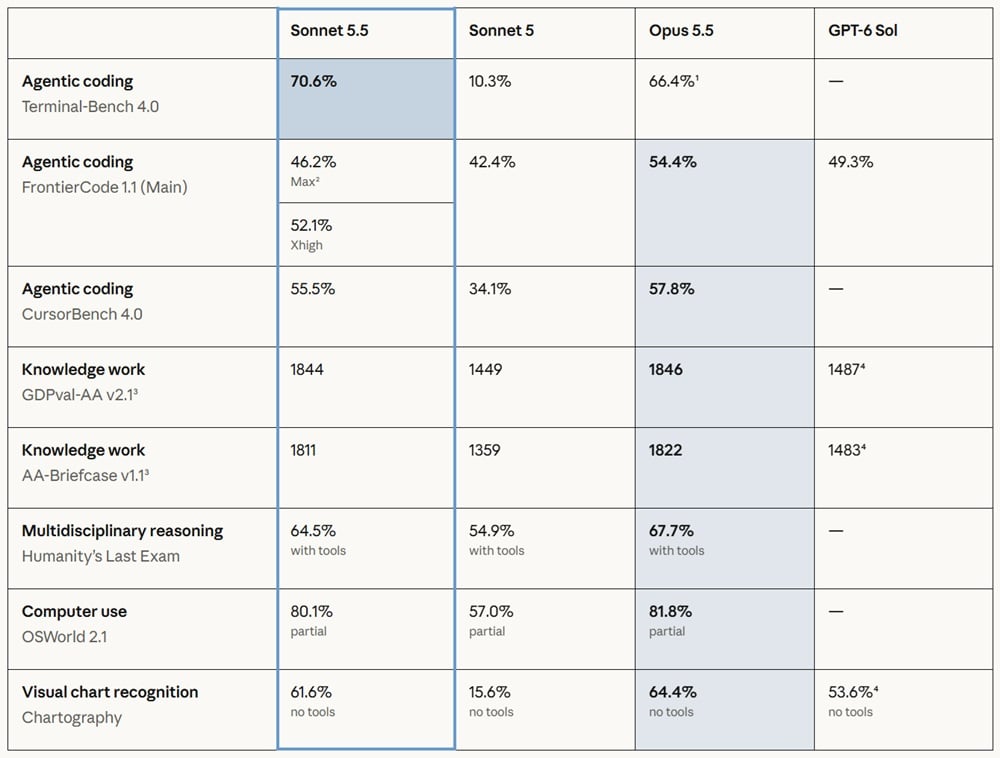
За Sonnet 5.5 работата на различни нива вече не е новост: моделът може да избира най-подходящото ниво на разсъждение за съответната задача. Според няколко теста Sonnet 5.5 max вече предлага производителност, близка до тази на Opus 5.5. При по-бързите и по-ефективни настройки пък надминава Sonnet 5, като разходите могат да бъдат до десет пъти по-ниски.
Claude Sonnet 5.5 е толкова сполучлив, че в отделни крайни случаи може дори да се окаже по-добър от Opus 5.5, при това на половината от цената.
В Terminal-Bench 4.0 например Sonnet 5.5 постига резултат от 70,6 %, докато по-големият модел достига 66,4 %. В GDPval-AA 2.1 вече изостава от Opus, но съвсем малко: получава 1.844 точки срещу 1.846 точки, докато GPT-6 Sol достига едва 1.487 точки. В FrontierCode 1.1, който оценява способностите за агентно програмиране, Sonnet 5.5 постига между 46,2 и 52,1 % според настройките. Opus 5.5 достига 54,4 %, а GPT-6 Sol отчита 49,3 % успеваемост.
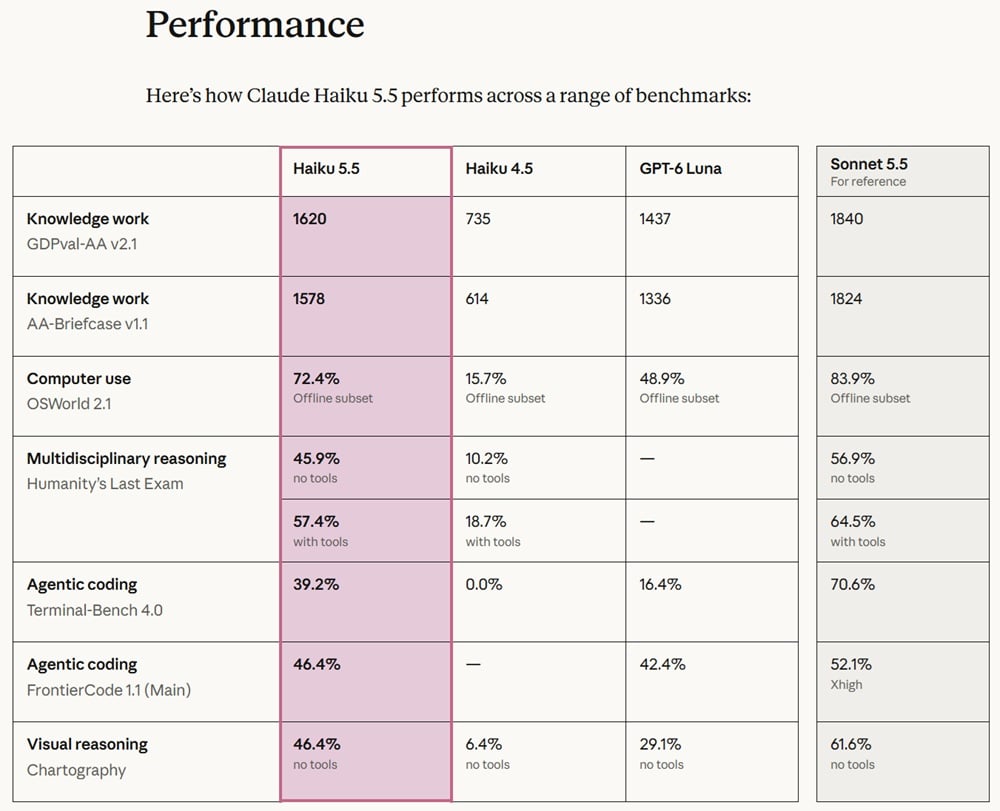
Според измерванията, споделени от Anthropic, Claude Haiku 5.5 постига 1.620 точки в GDPval-AA 2.1, който е насочен към работата с експертни знания. Така изпреварва дори GPT-6 Sol на OpenAI, въпреки че прекият му конкурент е GPT-6 Luna, достигнал едва 1.437 точки в този тест. В популярния и особено труден Humanity’s Last Exam с помощта на допълнителни инструменти моделът може да постигне 57,4 %. Така вече изпреварва Sonnet 5.5 без инструменти (56,9 %), въпреки че последният може да бъде до 20 пъти по-скъп. Подобна е ситуацията и във FrontierCode 1.1, където с резултат от 46,4 % Haiku вече достига нивото на Sonnet 5.5 с по-ниски настройки и уверено изпреварва GPT-6 Luna (42,4 %).
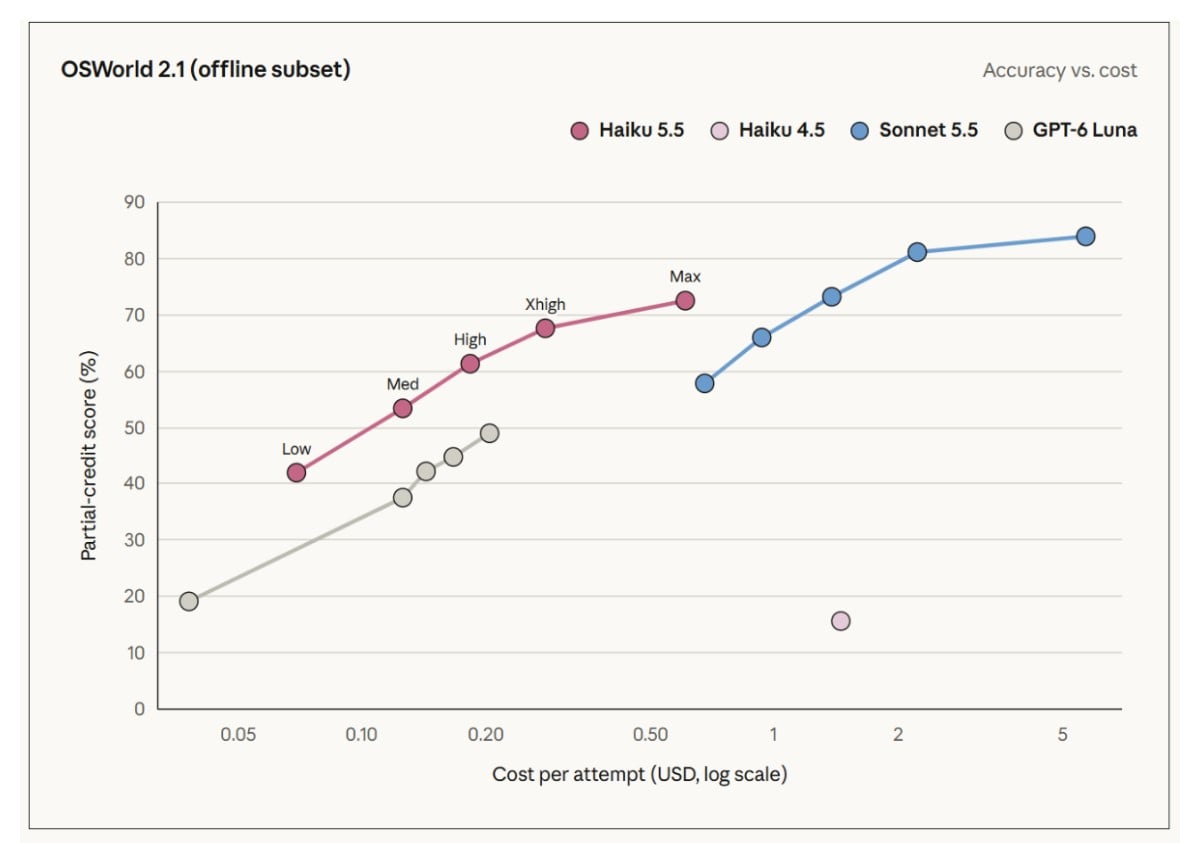
Anthropic подчертава, че с новите модели Claude 5.5 предлага изключително мащабируема система, например за програмиране. За бизнеса те образуват пакет, който позволява много по-добър контрол върху разходите при по-висока производителност и по-прецизна работа. Задачите, възложени на Claude Opus 5.5, могат да се изпълняват от агенти със Sonnet 5.5 под надзора на най-мощния модел. Sonnet 5.5 на свой ред може да създава подагенти с Haiku 5.5 за по-малките подзадачи. И CursorBench, и OSWorld отчитат отлични резултати при всички модели от серията.
По отношение на киберсигурността Haiku 5.5 разполага с по-строги защитни мерки от Haiku 4.5, а мерките му за биологична безопасност вече са на същото ниво като при моделите Sonnet и Opus. Anthropic работи с водещи специалисти в сектора за укрепване на сигурността . Автоматизираните проверки на поведението на моделите обхващат над 1.800 сценария, а Sonnet 5.5 бележи значителен напредък спрямо Sonnet 5 в почти всички отношения.
Новите модели станаха достъпни за потребителите веднага на всички платформи. При Claude Haiku 5.5 има отделни тарифи за заявки под 100.000 токена и за по-големи задачи. Докато задачата остава под 100.000 токена, обработката на 1 милион токена в рамките на цял разговор може да струва едва 0,1 долара, а генерирането на същото количество съдържание — 0,5 долара. При по-дълга заявка обаче тези разходи нарастват петкратно, съответно до 0,5 и 2,5 долара.
При по-способния Claude Sonnet 5.5 обработката на 1 милион токена струва 2 долара, а генерирането на също толкова токени — 10 долара. Това вече е значително по-скъпо, но трябва да се има предвид, че по производителност моделът се доближава много до Claude Opus 5.5, за който всички тарифи са двойно по-високи. Затова от гледна точка на ефективността по-новият модел безспорно е по-добрият избор. Подготвя се и Claude Fable 5.5, но Anthropic все още работи по него и той ще бъде значително по-скъп от разглежданите модели.