




Наред с водещите участници в надпреварата за изкуствен интелект много други компании вече разработват собствени модели, а Xiaomi укрепва позициите си и в тази област. Най-новият отворен модел на компанията, MiMo-V2.5, вече е на ниво, много близко до това на DeepSeek-V4, обявен няколко дни по-рано. При това решението на Xiaomi е дори по-евтино от китайския си конкурент.
MiMo-V2.5 използва архитектура Sparse Mixture-of-Experts (MoE), на която до голяма степен дължи изключителната си ефективност. Моделът разполага с общо 310 милиарда параметъра, но във всеки момент активни могат да бъдат най-много 15 милиарда от тях. Предлага се и вариант Pro, при който по-голям акцент е поставен върху производителността. Той също използва MoE архитектура, но има 1,02 трилиона параметъра и може да работи с 42 милиарда активни параметъра.
Xiaomi позволява на партньорите си да донастройват моделите и да ги обучават допълнително със собствени данни, за да постигат по-добри резултати в различни области. MiMo-V2.5-Pro е специално насочен към изпълнението на сложни задачи с ИИ агенти. Той е подходящ за логически разсъждения при обработка на големи обеми данни и може ефективно да изпълнява и задачи по програмиране. И двата нови модела разполагат с контекстен прозорец от 1 милион токена.
Разработчиците са създали MiMo-V2.5 с акцент върху изначално мултимодалната работа. Това означава, че моделът може безпроблемно да обработва изображения, видео и аудио успоредно с текстовите инструкции. Тази способност му помага да разсъждава по-ефективно, да отговаря по-точно и да проявява гъвкавост при изпълнението на задачи с ИИ агенти. Компанията подчертава, че базовият модел е обучен с огромен обем данни — 48 трилиона токена.
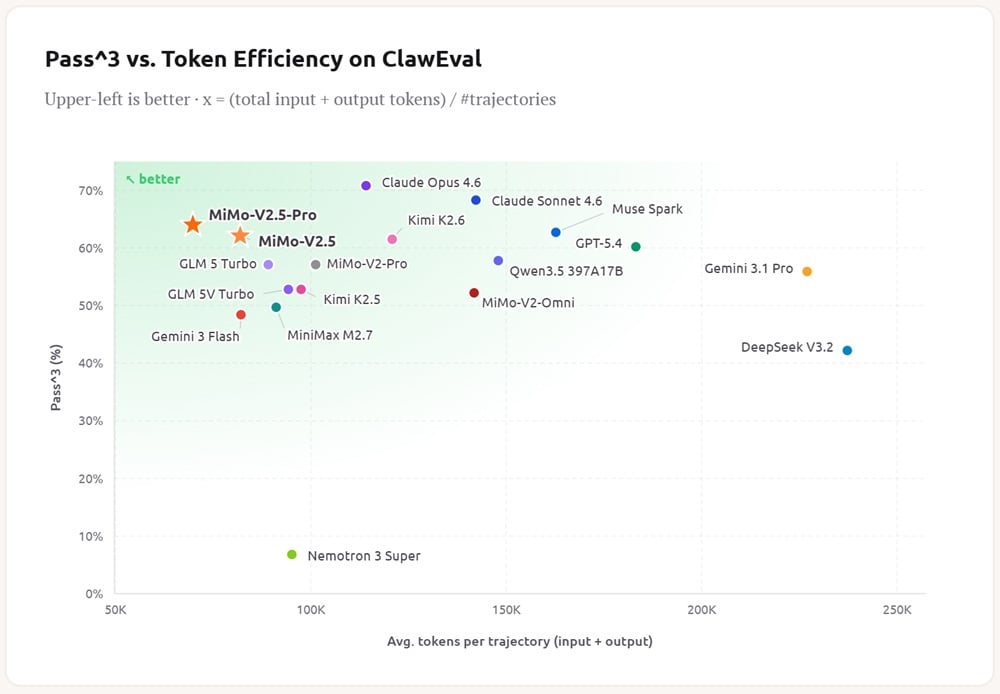
MiMo-V2.5 в момента е най-ефективният модел на пазара за изпълнение на задачи с „claw“ агенти, подчертава Xiaomi.
Новият модел е отлично решение за работа с OpenClaw, NanoClaw и подобни услуги, което звучи особено добре предвид огромната им популярност в момента. В теста ClawEval единствено моделите Claude изпреварват MiMo-V2.5, но не могат да се конкурират с него по ефективност.
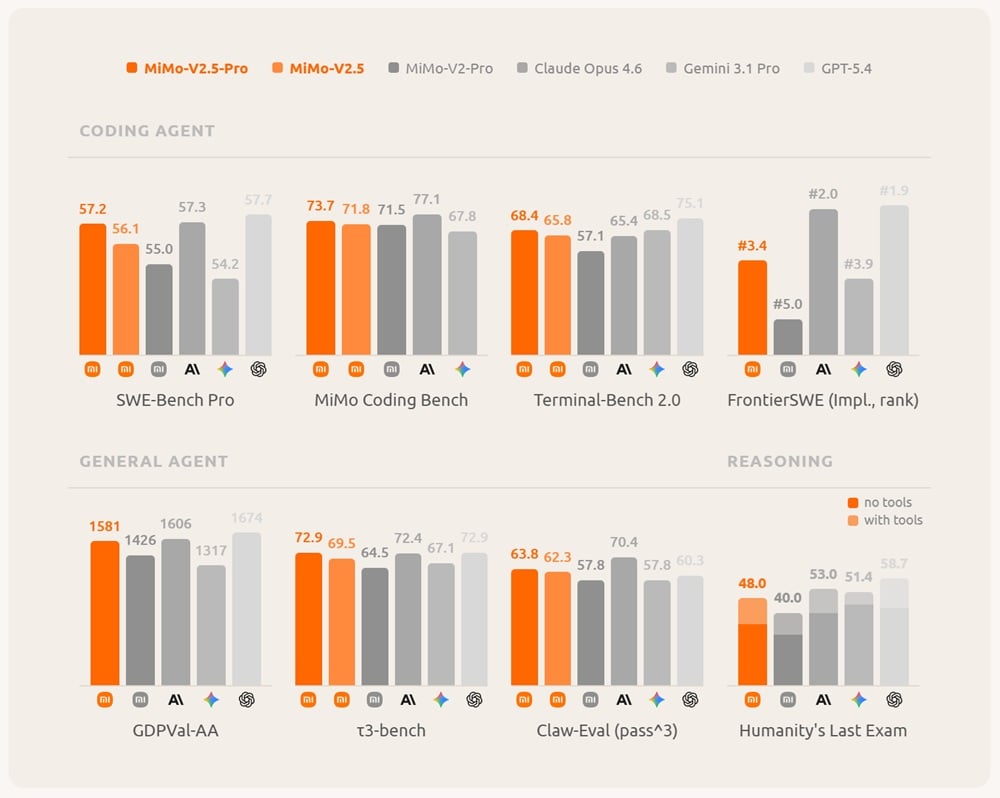
В собствените си измервания Xiaomi хитро е избрала да сравни MiMo-V2.5 с по-стари модели Opus и GPT, но новото ѝ предложение се представя прилично и спрямо най-новите модели. MiMo-V2.5-Pro постига 57,2 % в SWE-Bench Pro, докато GPT-5.5 отчита 58,6 %, а Claude Opus 4.7 достига 64,3 %. В Humanity's Last Exam моделът постига 34 % без „помощ“ срещу 43,1 % за GPT-5.5 Pro. Xiaomi изостава с приблизително поколение и половина, но трябва да се има предвид, че моделът ѝ работи със значително по-малко ресурси от споменатите конкуренти.
DeepSeek привлече широко внимание с ниските си разходи за работа: моделите му постигат резултати, много близки до тези на западните конкуренти, на многократно по-ниска цена. Xiaomi подхожда по сходен начин към езиковите модели и в резултат MiMo-V2.5 е дори по-изгоден от DeepSeek-V4. При MiMo-V2.5-Pro обработката на 1 милион токена струва само 1 долар, а генерирането на същото количество съдържание — 3 долара. При MiMo-V2.5 разходите за обработка и генериране на 1 милион токена са съответно едва 0,4 и 2 долара.
Xiaomi работи и по MiMo-V2.5-Flash, който според плановете ще бъде моделът с най-ниски разходи за работа сред по-известните езикови модели. Използването му ще струва приблизително наполовина спрямо Grok 4.1 Flash, който в момента е най-евтиният. Цената ще бъде 0,1 долара за 1 милион входни токена и 0,3 долара за същия брой изходни токени.
Моделите MiMo-V2.5 са „изцяло“ с отворен код и са общодостъпни, включително за търговска употреба. Xiaomi предоставя свобода, каквато малко компании предлагат в тази област: партньорите дори не са задължени да подлагат на последваща проверка моделите, донастроени със собствени данни.